En los últimos tiempos estamos viendo un ritmo frenético de innovación en modelos de IA open-weight (o modelos de pesos abiertos) que prometen “IA gratuita e ilimitada” corriendo en equipos de uso doméstico. Y las cifras empiezan a ser sorprendentes: un MacBook Pro con M4 Max puede incorporar hasta 128 GB de memoria unificada y 546 GB/s de ancho de banda, mientras que un Mac Studio con M3 Ultra llega hasta los 512 GB y supera los 800 GB/s. Apple afirma que este último puede ejecutar localmente modelos de lenguaje de más de 600.000 millones de parámetros.
La evolución de los propios modelos es igual de importante. Arquitecturas Mixture of Experts (MoE) permiten construir modelos enormes activando únicamente una fracción de sus parámetros en cada inferencia. Qwen3-30B-A3B, por ejemplo, tiene 30.000 millones de parámetros pero activa aproximadamente 3.000 millones por token. La combinación de modelos más eficientes, cuantización y hardware con grandes cantidades de memoria unificada está reduciendo rápidamente la distancia entre la IA disponible en grandes datacenters y la que podemos ejecutar de forma privada y local en nuestros propios equipos.
Ahora bien, que la distancia se haya reducido no significa que los modelos frontier en la nube hayan dejado de ser necesarios. Cuando una tarea exige razonamiento complejo, capacidades agentic avanzadas o cuando la latencia y el throughput —TTFT (time to first token) y velocidad de inferencia en tokens per second— son factores determinantes, la infraestructura cloud y los modelos frontier siguen teniendo ventajas importantes.
La cuestión es que los canales de YouTube dedicados a IA local se multiplican, y los debates entre los local AI fanboys y los frontier AI fanboys se suceden sin que exista realmente un ganador: están discutiendo cosas distintas.
Desde mi punto de vista, el modelo de uso óptimo es la IA híbrida: combinar modelos locales y modelos en la nube para optimizar costes, disponer de mecanismos de contingencia que reduzcan la dependencia de un único proveedor y contar con una alternativa cuando manejamos información que preferimos no enviar fuera de nuestros propios sistemas.
De esa visión nació Minix. Es un experimento funcional que ya utilizo como mi asistente personal: mantengo una única conversación y el sistema decide, para cada petición, dónde tiene más sentido ejecutar la inteligencia.
No quiero elegir un modelo cada vez que escribo. Quiero resolver una traducción breve localmente y recurrir al cloud cuando necesito un razonamiento más exigente. Y quiero saber cuándo ocurre cada cosa.
El servidor de Minix: un Mac mini M4 Pro con 24 GB#
El servidor de LiteLLM es un Mac mini con Apple M4 Pro y 24 GB de memoria unificada. Es el punto de entrada a los modelos: recibe las peticiones de Minix, ejecuta la selección de ruta y conecta el agente con la inferencia local o con el proveedor cloud. La inferencia local se sirve mediante LM Studio. No necesito una granja de servidores para experimentar con esta arquitectura; sí necesito respetar la memoria disponible y no cargar simultáneamente dos modelos grandes.
Este Mac es una dependencia compartida: si falla el cloud, la ruta local puede seguir disponible; si se detiene el propio servidor de LiteLLM, tener dos destinos de inferencia no garantiza continuidad. El fallback entre modelos y la alta disponibilidad del gateway son problemas distintos.
Una conversación, tres LLMs y un router#
Hablo con Minix por Matrix. Hermes mantiene el historial y el bucle del agente: recibe mi mensaje, llama al modelo, ejecuta herramientas si corresponde y devuelve la respuesta. LiteLLM ofrece un punto de entrada común, minix-smart, detrás del cual trabaja el router de complejidad.
minix-smart no es un LLM. Es un alias de routing. Para entender el sistema hay que separar los modelos que piensan de los componentes que transportan, clasifican y encaminan sus llamadas.
| Función | Alias o componente | Modelo configurado | Papel en la prueba |
|---|---|---|---|
| Clasificar la petición localmente | minix-classifier | qwen35-08b-classifier-bench | Seis decisiones, una por turno |
| Generar respuestas locales | minix-local, servido por LM Studio | google/gemma-4-12b | T1, T3 y T5 |
| Generar respuestas cloud | minix-cloud | chatgpt/gpt-5.5 | T2, T4 y T6 |
| Atender la categoría REASONING | minix-think | chatgpt/gpt-5.5 | Ruta configurada, no utilizada en estos seis turnos |
Son tres modelos distintos, no cuatro: minix-cloud y minix-think apuntan al mismo nombre de modelo cloud. SIMPLE y MEDIUM se encaminan a minix-local; COMPLEX a minix-cloud; REASONING a minix-think. El default si falla la clasificación es minix-cloud: no debo confundir esa política con una recuperación local ante una caída del cloud. La afinidad de sesión está desactivada, de modo que una respuesta cloud no fija el destino de toda la conversación.
Uso aquí los alias actuales. La prueba histórica y sus apéndices conservan los nombres anteriores: kathy-smart → minix-smart, kathy-local → minix-local, kathy-classifier → minix-classifier, kathy-premium → minix-cloud y kathy-codex → minix-think. El sexto alias, minix-smart-mlx, es auxiliar y ya existía; no lo convierto en una ruta adicional de este experimento. minix-think conserva reasoning_effort: high, que ya estaba configurado antes de la migración. La tabla relaciona las funciones actuales con los turnos históricos, no con una nueva ejecución.
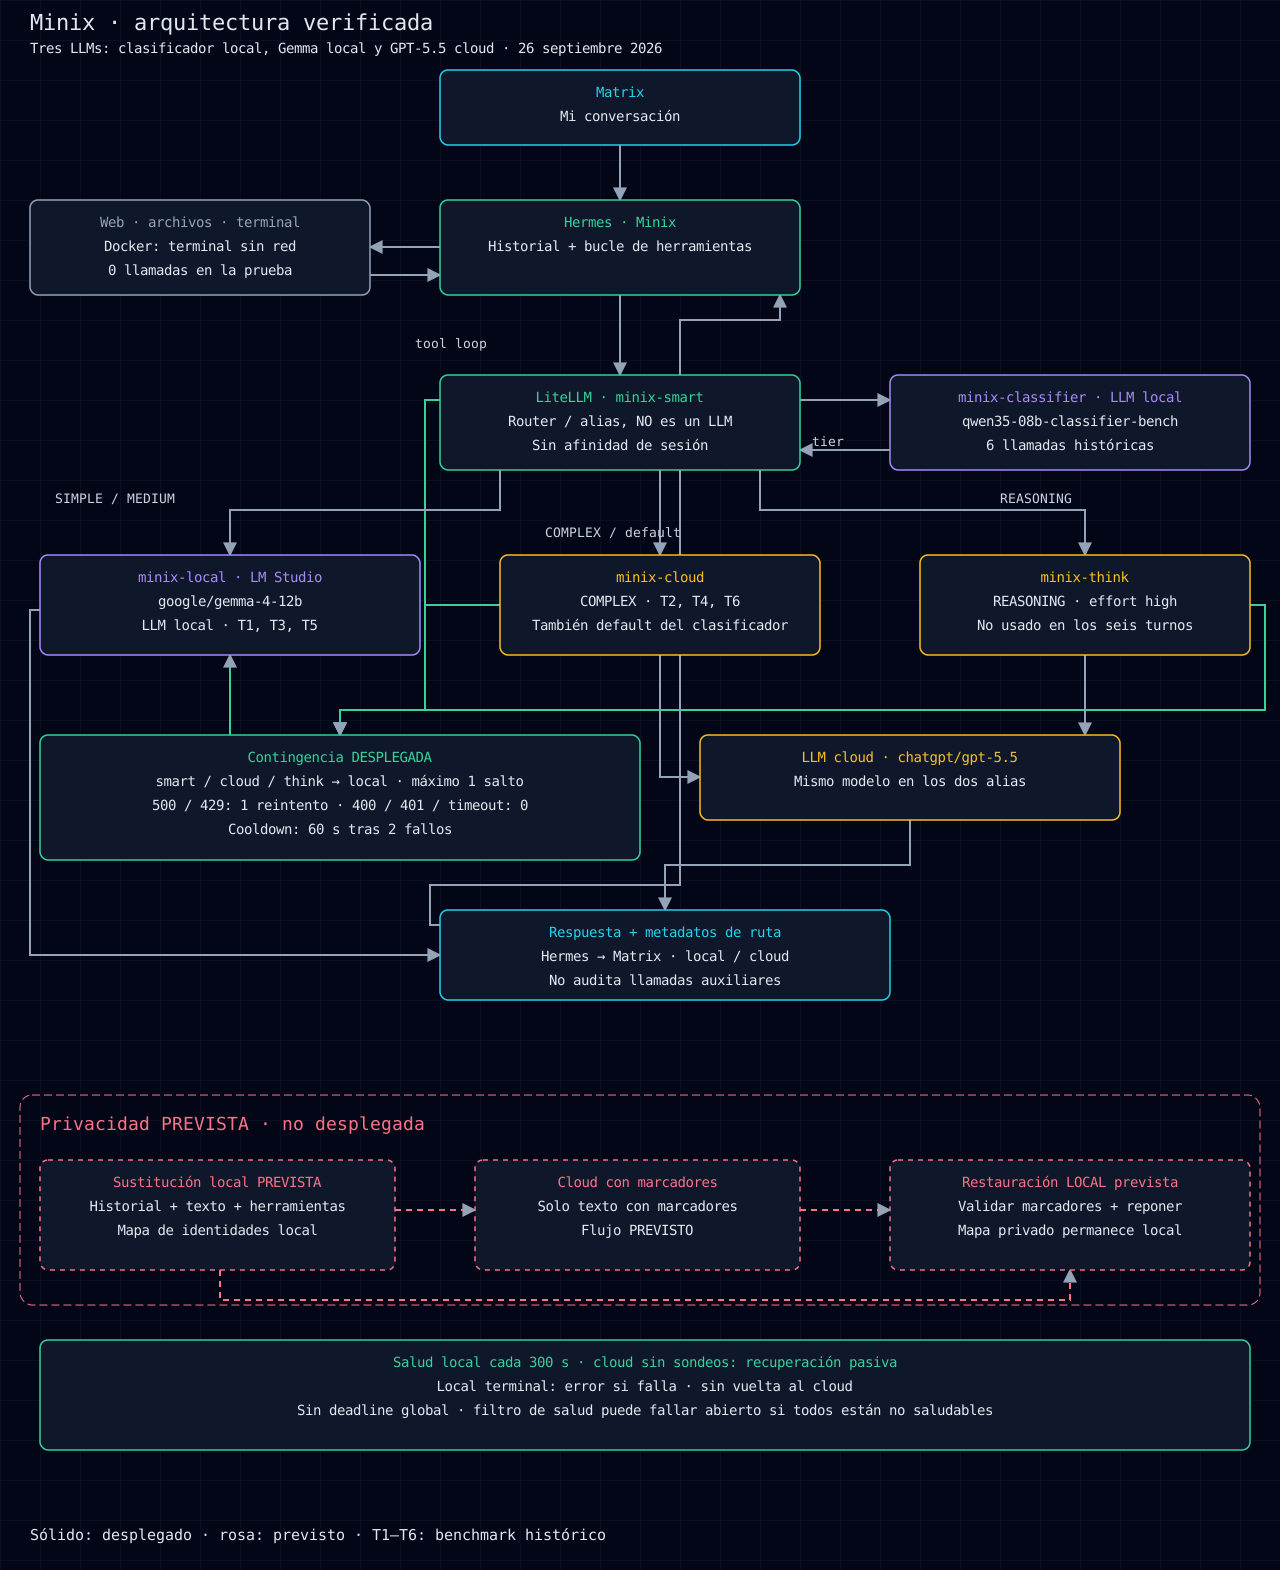
El dibujo muestra el flujo configurado, incluida la ruta REASONING que no apareció en la prueba. La privacidad prevista aparece separada y en rosa discontinua; la contingencia desplegada, en verde. Los turnos y llamadas indicados son los del benchmark histórico. Tengo herramientas web y de archivos, además de un terminal Docker sin red; eso no convierte las herramientas web en locales ni demuestra aislamiento de todo el agente. En estos seis turnos no se invocó ninguna herramienta ni un modelo auxiliar de visión; no añado un cuarto LLM sin evidencia.
Código del diagrama editable
flowchart TB
  M["Matrix<br/>Mi conversación"]
  H["Hermes · Minix<br/>Historial + bucle de herramientas"]
  T["Web · archivos · terminal<br/>Docker: terminal sin red<br/>0 llamadas en la prueba"]
  R["LiteLLM · minix-smart<br/>Router / alias, NO es un LLM<br/>Sin afinidad de sesión"]
  Q["minix-classifier · LLM local<br/>qwen35-08b-classifier-bench<br/>6 llamadas históricas"]
  L["minix-local · LM Studio<br/>google/gemma-4-12b<br/>LLM local · T1, T3, T5"]
  P["minix-cloud<br/>COMPLEX · T2, T4, T6<br/>También default del clasificador"]
  C["minix-think<br/>REASONING · effort high<br/>No usado en los seis turnos"]
  G["LLM cloud · chatgpt/gpt-5.5<br/>Mismo modelo en los dos alias"]
  O["Respuesta + metadatos de ruta<br/>Hermes → Matrix · local / cloud<br/>No audita llamadas auxiliares"]
  S["Sustitución local PREVISTA<br/>Historial + texto + herramientas<br/>Mapa de identidades local"]
  K["Cloud con marcadores<br/>Solo texto con marcadores<br/>Flujo PREVISTO"]
  F["Contingencia DESPLEGADA<br/>smart / cloud / think → local · máximo 1 salto<br/>500 / 429: 1 reintento · 400 / 401 / timeout: 0<br/>Cooldown: 60 s tras 2 fallos"]
  M --> H
  H --> T
  T --> H
  H --> R
  R --> Q
  Q --> |"tier"| R
  R --> |"SIMPLE / MEDIUM"| L
  R --> |"COMPLEX / default"| P
  R --> |"REASONING"| C
  P --> G
  C --> G
  L --> O
  G --> O
  O --> |"tool loop"| H
  S -.-> K
  V["Restauración LOCAL prevista<br/>Validar marcadores + reponer<br/>Mapa privado permanece local"]
  D["Salud local cada 300 s · cloud sin sondeos: recuperación pasiva<br/>Local terminal: error si falla · sin vuelta al cloud<br/>Sin deadline global · filtro de salud puede fallar abierto si todos están no saludables"]
  K -.-> V
  S -.-> V
  R --> |"fallback"| F
  P --> |"fallback"| F
  C --> |"fallback"| F
  F --> L
  classDef planned fill:#2b1725,stroke:#fb7185,stroke-dasharray:5 5,color:#ffffff
  class S,K,V planned
  classDef deployed fill:#064e3b,stroke:#34d399,color:#ffffff
  class F,D deployed
La respuesta lleva una marca: 🖥️ para generación local y ☁️ para generación cloud. La añade el sistema a partir de metadatos de la ruta servida, no el modelo describiéndose a sí mismo. Identifica la generación final, no audita todas las llamadas auxiliares de una tarea con herramientas.
He contrastado los nombres y mapeos con la configuración y los artefactos del experimento. Los logs corroboran directamente Gemma y el clasificador. En el híbrido no se archivó el header bruto de cada respuesta cloud: la categoría cloud está respaldada por el marcador y su código de renderizado, y GPT-5.5 por el mapeo configurado. En el baseline sí se conservaron los seis headers del deployment kathy-premium. Eso identifica el deployment, no un fingerprint independiente de los pesos del proveedor.
La prueba: volver al local después de usar el cloud#
Preparé seis peticiones sobre un mismo proyecto, Puente, un sincronizador de archivos entre dos servidores que pueden trabajar desconectados. Fijé los prompts antes de empezar, sin pedir una ruta concreta ni ajustar el clasificador durante la prueba. Conservé la conversación existente, incluido su historial anterior.
La secuencia fue local → cloud → local → cloud → local → cloud:
- T1, local: una bienvenida y tres nombres alternativos. Gemma respondió con Nexo, Vínculo y Nodo.
- T2, cloud: metadatos, reglas de fusión, pseudocódigo, tombstones y análisis de convergencia. La respuesta propuso causalidad y variantes concurrentes, pero no una prueba completa del algoritmo.
- T3, local: extracción literal de tres valores. Devolvió
nombre=Puente,nodos=A,Bypolítica=conservar conflictos, exactamente como pedía el prompt. - T4, cloud: un conflicto concreto entre edición y borrado. La respuesta conservó las variantes
(2,1)y(1,2), resumió el contexto como(2,2)y explicó una resolución posterior(3,2). - T5, local: una traducción breve al inglés: «Puente preserves concurrent edits and requires explicit resolution of conflicts.»
- T6, cloud: revisión crítica de tres atajos peligrosos: escoger un contenido por hash, recolectar tombstones demasiado pronto y reutilizar una identidad con el contador a cero.
Lo interesante no es solo que una pregunta difícil llegue al cloud. Es que la siguiente pregunta sencilla vuelve al local conservando la conversación. No necesito abrir otro chat ni trasladar yo el contexto.
Para poder revisar lo ocurrido sin depender de mi resumen, incluyo los seis prompts y las doce respuestas completas, híbridas y cloud, al final de este artículo. Conservo el texto original, incluidos sus errores; no lo he reconstruido ni corregido para que la prueba parezca mejor.
Hubo seis respuestas finales en cada ejecución, sin herramientas ni reintentos observados. Las tareas sencillas fueron satisfactorias en ambas. Las complejas aportaron ideas útiles, pero mantuvieron lagunas sobre fusión general de conflictos y recolección segura de versiones. Mi revisión no fue ciega ni demuestra equivalencia estadística de calidad: escoger un modelo cloud no convierte su respuesta en una prueba formal.
Qué medí y qué significa el 48%#
Benchmark histórico, anterior a la migración de alias y a la nueva política de contingencia. Conservo las medidas originales sin cambios; no describen una repetición con la configuración actual.
Registré los tokens de entrada y salida, incluido el contexto de cada llamada. Después repetí los mismos seis prompts en una ejecución íntegramente cloud, acumulando sus propias respuestas, no las del híbrido.
| Turno | Ruta híbrida | Tokens locales de respuesta | Tokens cloud híbridos | Tokens cloud del baseline |
|---|---|---|---|---|
| T1 | local | 7.351 | 0 | 8.257 |
| T2 | cloud | 0 | 9.356 | 9.368 |
| T3 | local | 8.650 | 0 | 9.441 |
| T4 | cloud | 0 | 10.284 | 10.301 |
| T5 | local | 9.631 | 0 | 10.379 |
| T6 | cloud | 0 | 11.316 | 11.454 |
| Total | 25.632 | 30.956 | 59.200 |
Son totales de entrada más salida, no solo el texto visible. El baseline suma 56.550 de entrada + 2.650 de salida; la parte cloud del híbrido, 28.510 + 2.446. El clasificador consumió otros 2.014 tokens locales y unos 1,71 segundos acumulados, aparte de las llamadas de respuesta.
La diferencia observada es:
(59.200 − 30.956) / 59.200 × 100 = 47,71%: 28.244 tokens cloud menos.
No he convertido los 25.632 tokens locales en supuestos tokens cloud ahorrados: comparo el consumo cloud de dos ejecuciones reales. Tampoco he eliminado ese trabajo; he trasladado parte a infraestructura local. Los 14.336 tokens de caché cloud del híbrido y los 15.360 del baseline ya están incluidos en la entrada, no sumados dos veces. Los distintos tokenizadores impiden interpretar la suma local/cloud como cómputo equivalente.
Es una comparación indicativa, no un ahorro causal controlado ni universal. Recuperé el historial inicial disponible y las herramientas, pero no todas las instrucciones dinámicas originales con exactitud. El híbrido pasó por Matrix y el baseline por API; sus respuestas y cachés evolucionaron de forma distinta. Una conversación de seis turnos tampoco mide la precisión general del clasificador.
La afirmación defendible es: en esta prueba, Minix utilizó aproximadamente un 48% menos de tokens cloud que una ejecución comparable íntegramente en la nube. No significa un 48% menos de factura ni más velocidad: no he calculado costes monetarios, electricidad, hardware o mantenimiento, ni he realizado un benchmark controlado de latencia.
Continuidad: contingencia reactiva ya desplegada#
He desplegado una política acotada en LiteLLM: minix-cloud, minix-think y minix-smart pueden recurrir a minix-local, con un máximo de un salto de fallback. El local es terminal: si también falla, la petición termina con error, sin volver al cloud ni abrir un ciclo. No es una promesa de que Gemma resuelva cualquier tarea con la misma calidad.
Para errores cloud HTTP 500 y 429 permito un reintento; para 400, 401 y timeouts, cero reintentos. No reintentar no equivale a desactivar el fallback. Tras el segundo fallo, el deployment entra en un cooldown de 60 segundos. Conservo los timeouts de inferencia existentes; no hay un plazo máximo global estricto para toda la secuencia.
Compruebo periódicamente la salud local cada 300 segundos. No hago sondeos cloud en segundo plano: su recuperación es pasiva, cuando vence el cooldown y una nueva petición vuelve a probar la ruta. Si todos los destinos aparecen como no saludables, el filtro de salud puede permitir intentarlos de nuevo (fail-open); eso no cambia que un fallo final del local termine la petición. Los dos alias cloud comparten proveedor y modelo: no son redundancia independiente.
La verificación distingue pruebas de fallos y uso real. Dispongo de 28 pruebas unitarias aprobadas y evidencia previa de 12 casos loopback aislados, no repetidos durante esta migración. No provoqué una caída en producción. En producción comprobé respuestas streaming HTTP 200 de local, cloud y think sin fallback, con contenido, finalización y sus identificadores de ruta exactos; también probé smart y confirmé una respuesta final local real en Matrix. Esto valida esas rutas, no todos los modos de la API.
Queda una limitación concreta: la llamada cloud no streaming devuelve Unknown items in responses API response: []. Reproduje el mismo fallo con la configuración anterior; no lo atribuyo a la migración ni lo doy por resuelto. La ruta streaming sí superó la comprobación.
El fallback de inferencia no implica reevaluación semántica de la tarea, aviso automático de modo degradado ni protección demostrada frente a repetir herramientas con efectos externos. No afirmo haber validado esos comportamientos. Consultar un servicio externo caído tampoco se vuelve posible por cambiar de modelo. Deben seguir disponibles el runtime, el almacenamiento y el canal: la inferencia local no garantiza que un chat remoto sobreviva a una pérdida de conexión.
Privacidad: enviar el problema, no necesariamente las identidades#
La otra decisión que quiero incorporar no es de dificultad, sino de datos: ¿qué información necesita salir de mi entorno para resolver la tarea?
El mecanismo previsto sustituiría localmente datos sensibles por identificadores consistentes, manteniendo el mapa de correspondencias bajo control local, con acceso restringido y una vida limitada a la tarea. Por ejemplo, mi petición ficticia:
«Prepara un correo para Elena, de Taller Norte, sobre el proyecto Brisa».
se convertiría, antes de salir, en:
«Prepara un correo para [PERSONA_1], de [EMPRESA_1], sobre el proyecto [PROYECTO_1]».
El cloud redactaría usando esos marcadores. A la vuelta, la capa local validaría cada identificador y repondría los valores originales para mí. La misma persona conservaría el mismo marcador dentro de la tarea; uno desconocido o alterado no daría permiso para inventar nombres ni recuperar otra correspondencia.
No bastaría con limpiar el último mensaje. Quiero aplicar el control a todo lo que sale: historial, documentos, resultados de herramientas y metadatos pertinentes. Un adjunto que no pueda tratarse con seguridad debería quedarse local o excluirse. Si resolver la tarea exige revelar una identidad, la alternativa sería mantenerla local, pedirme autorización específica o explicar la limitación, no enviar el original silenciosamente.
Esto es seudonimización reversible, no anonimato garantizado. El contexto puede revelar identidades aunque desaparezcan los nombres; la detección y los marcadores también pueden fallar. Por eso incluyo validación de salida, registros sin secretos y un tratamiento conservador de los casos dudosos en el comportamiento que busco.
Mi asistente, no una guerra entre modelos#
No uso Minix para demostrar que el local sustituye siempre al cloud, ni al revés. Lo uso para escoger dónde ejecutar cada tarea sin tener que gestionar manualmente esa elección.
El experimento ya me permite observar algo concreto: una conversación que vuelve al local después de pasar por el cloud, con un consumo cloud menor en la comparación realizada. La contingencia reactiva ya está desplegada; el control de datos sigue siendo el siguiente paso, sin borrar los límites de lo que he medido.
La pregunta deja de ser «¿cuál es el modelo más potente?» y pasa a ser otra más útil:
¿Qué parte de esta tarea necesita realmente salir de mi entorno?
Conversaciones completas: los seis turnos#
Conservo aquí los seis prompts originales y las doce respuestas completas: una respuesta híbrida y una íntegramente cloud por turno. Cada ejecución acumuló sus propias respuestas; las presento juntas para facilitar la revisión, no como si fueran una sola conversación.
Los bloques son transcripciones literales en el idioma original (español, salvo las traducciones solicitadas en T5). Mantengo incluso los plurales y las afirmaciones discutibles del material citado; no los convierto en mi voz editorial. Los identificadores de experimento forman parte de los prompts. Los iconos de la ejecución híbrida son metadatos añadidos por el sistema, no palabras generadas por el modelo. No incluyo instrucciones internas, historial anterior, identificadores de Matrix ni credenciales.
Lectura crítica: las tareas sencillas son satisfactorias en ambas ejecuciones. Los diseños de T2 no demuestran una fusión general de conjuntos de conflictos; T4 resuelve el ejemplo concreto, no esa prueba general. T6 aporta riesgos y propiedades útiles, pero no demuestra condiciones mínimas de recolección. En el baseline, rechazar operaciones antiguas dominadas no debe confundirse con descartar ediciones concurrentes legítimas. No ejecuté aquí ningún sincronizador distribuido ni una evaluación ciega de calidad.
Índice#
T1#
Mi prompt original#
[MXHYB-20260926-A T1] Vamos a diseñar juntos un pequeño sincronizador de archivos entre dos servidores que pueden trabajar desconectados, A y B. Lo llamaremos Puente. De momento, responde en español con una bienvenida de una frase y tres nombres alternativos cortos. No crees archivos ni ejecutes nada.Respuesta híbrida — local#
🖥️ Bienvenido al diseño del proyecto Puente para la sincronización entre servidores.

Nombres alternativos: Nexo, Vínculo, Nodo.
Respuesta íntegramente cloud#
Bienvenido a Puente: podemos diseñar un sincronizador simple, robusto y preparado para desconexiones entre A y B.

- Nexo
- Brisa
- TramaT2#
Mi prompt original#
[MXHYB-20260926-A T2] Sigamos con Puente. A y B pueden editar o borrar el mismo archivo mientras están desconectados; los relojes físicos no son fiables y la red duplica y reordena mensajes. Diseña un algoritmo de sincronización que converja sin perder silenciosamente ediciones concurrentes. Especifica metadatos, reglas de fusión, tombstones y condiciones para recolectarlos. Da pseudocódigo y justifica convergencia e idempotencia; incluye un contraejemplo a elegir siempre la fecha más reciente. Unas 450 palabras, sin ejecutar ni crear archivos.Respuesta híbrida — nube#
☁️ Un diseño seguro para Puente debe tratar cada archivo como un objeto replicado con historial causal, no como “el último gana”.

**Metadatos por archivo**
- `id`: ruta lógica o identificador estable.
- `replica_id`: `A` o `B`.
- `version_vector`: mapa `{replica_id: contador}` que resume las actualizaciones conocidas.
- `dot`: par único `(replica_id, contador)` de la operación local.
- `content_hash`: hash del contenido, si existe.
- `deleted`: booleano.
- `tombstone`: registro de borrado con `dot`, `version_vector` y fecha local solo informativa.
- `conflicts`: conjunto de variantes concurrentes, cada una con contenido y metadatos causales.

Los relojes físicos no deciden nada. Solo sirven para mostrar información al usuario.

**Reglas**
Cada edición local incrementa el contador propio y crea una nueva versión causal. Cada borrado crea un tombstone, no elimina inmediatamente el registro. Al sincronizar, se comparan vectores:

- Si `remote.version_vector <= local.version_vector`, el remoto ya está incluido: ignorar.
- Si `local.version_vector <= remote.version_vector`, aceptar remoto.
- Si ninguno domina al otro, hay concurrencia:
  - edición vs edición: conservar ambas variantes en `conflicts`, o intentar fusión automática si el tipo lo permite; si la fusión no es limpia, exponer conflicto.
  - edición vs borrado: no borrar silenciosamente; conservar la edición como conflicto contra tombstone.
  - borrado vs borrado: fusionar tombstones tomando la unión causal.

**Pseudocódigo**

```text
edit(file, content):
  clock[self] += 1
  dot = (self, clock[self])
  file.content = content
  file.deleted = false
  file.version_vector[self] = clock[self]
  file.dot = dot
  file.conflicts = {}

delete(file):
  clock[self] += 1
  dot = (self, clock[self])
  file.content = null
  file.deleted = true
  file.tombstone = {dot, version_vector + self counter}
  file.version_vector[self] = clock[self]

merge(local, remote):
  if dominates(local.vv, remote.vv):
    return local

  if dominates(remote.vv, local.vv):
    return remote

  merged.vv = pointwise_max(local.vv, remote.vv)

  if local.deleted and remote.deleted:
    merged.deleted = true
    merged.tombstone = merge_tombstones(local, remote)
    return merged

  if not local.deleted and not remote.deleted:
    result = try_semantic_merge(local.content, remote.content)
    if result.clean:
      merged.content = result.content
      merged.conflicts = {}
    else:
      merged.content = null
      merged.conflicts = {variant(local), variant(remote)}
    return merged

  merged.deleted = false
  merged.content = null
  merged.conflicts = {variant(local), variant(remote)}
  return merged
```

**Tombstones y recolección**
Un tombstone solo puede eliminarse cuando todas las réplicas conocidas han observado causalmente el borrado. Con dos servidores, A puede recolectar un tombstone de B cuando sabe que B ha recibido un vector que domina el vector del tombstone, y viceversa. En sistemas ampliables, hace falta un mecanismo de membresía estable o acknowledgements por réplica. Si hay réplicas desconocidas o restauraciones desde copias antiguas, no se debe recolectar aún.

**Convergencia e idempotencia**
La convergencia viene de usar una unión determinista: máximo punto a punto de vectores, preservación de variantes concurrentes y reglas simétricas. Si A y B reciben los mismos estados, acaban calculando el mismo resultado. La idempotencia se obtiene porque reentregar el mismo mensaje no cambia nada: un vector ya dominado se ignora, y los conflictos se identifican por `dot` o hash causal, no por número de recepción.

**Contraejemplo al “más reciente gana”**
A edita `informe.txt` a “versión legal” con reloj adelantado a las 12:10. B, desconectado, edita a “versión financiera” con reloj atrasado a las 12:05. Ambas ediciones son concurrentes y válidas. Elegir la fecha más reciente descarta silenciosamente la versión financiera, aunque no fue sobrescrita causalmente por A.
Respuesta íntegramente cloud#
Propongo que Puente use versiones causales, no fechas físicas. Cada servidor replica un conjunto de objetos CRDT por ruta lógica, con detección explícita de conflictos.

**Metadatos por archivo**

- `node_id`: `A` o `B`.
- `version_vector`: mapa `{nodo: contador}` que identifica causalidad.
- `content_hash`: hash del contenido.
- `op_id`: par único `(node_id, contador)`.
- `deleted`: booleano.
- `tombstone`: si está borrado, guarda `delete_vector`, `delete_op_id` y fecha local solo informativa.
- `conflicts`: conjunto de variantes concurrentes, cada una con contenido/hash/vector.

Cada operación local incrementa el contador del nodo. Una edición genera una versión con `deleted=false`; un borrado genera una tombstone con `deleted=true`.

**Reglas de sincronización**

Al recibir un estado remoto para una ruta:

```pseudo
function dominates(v1, v2):
    return forall n: v1[n] >= v2[n] and exists n: v1[n] > v2[n]

function concurrent(v1, v2):
    return not dominates(v1, v2) and not dominates(v2, v1)

function merge(local, remote):
    if remote.op_id already_seen:
        return local

    mark_seen(remote.op_id)

    if dominates(remote.vector, local.vector):
        return remote

    if dominates(local.vector, remote.vector):
        return local

    if concurrent(local.vector, remote.vector):
        return resolve_concurrent(local, remote)
```

La resolución concurrente no debe descartar silenciosamente. Para archivos binarios o cambios incompatibles:

```pseudo
function resolve_concurrent(x, y):
    if x.deleted and y.deleted:
        return tombstone(union_vector(x.vector, y.vector))

    if x.deleted and not y.deleted:
        return conflict_record(
            visible = y,
            conflicts = [tombstone_variant(x)]
        )

    if not x.deleted and y.deleted:
        return conflict_record(
            visible = x,
            conflicts = [tombstone_variant(y)]
        )

    if same content_hash:
        return version(content=x.content, vector=union_vector(x.vector, y.vector))

    if textual_auto_merge_possible(x.content, y.content, base):
        return merged_file(
            content=three_way_merge(base, x, y),
            vector=union_vector(x.vector, y.vector),
            conflicts=[]
        )

    return conflict_record(
        visible = deterministic_choice(x, y),   // solo para presentación
        conflicts = [x, y],
        vector = union_vector(x.vector, y.vector)
    )
```

En disco, un conflicto puede exponerse como `archivo`, `archivo.conflict-A`, `archivo.conflict-B` o como un manifiesto. Lo importante: ambas ediciones quedan accesibles.

**Tombstones**

Una tombstone representa “esta ruta fue borrada en esta causalidad”. Debe propagarse igual que una edición para evitar que una réplica antigua resucite el archivo. Puede recolectarse solo cuando todos los nodos conocidos han observado el borrado:

```pseudo
function can_gc_tombstone(t):
    return forall node in membership:
        ack_vector[node] >= t.delete_vector[node]
```

Si la membresía cambia, hace falta un protocolo de épocas: no se recolectan tombstones de una época hasta que todos los miembros de esa época hayan acusado recibo, o hasta que exista una instantánea completa posterior aceptada por todos los miembros activos.

**Convergencia e idempotencia**

Converge porque la fusión es determinista, conmutativa y asociativa sobre vectores causales y conjuntos de variantes. Los mensajes duplicados no cambian el resultado porque `op_id` y los hashes hacen la aplicación idempotente. El reordenamiento no importa: si llega primero una versión antigua, luego será dominada; si llegan versiones concurrentes, se conservan ambas.

**Contraejemplo a “fecha más reciente”**

A y B editan `nota.txt` desconectados. A escribe “precio 10” a las 10:05, pero su reloj va adelantado; B escribe “precio 12” a las 10:01 reales, con reloj atrasado marcando 09:50. Al reconectar, elegir la fecha más reciente conserva A y borra B, aunque son cambios concurrentes y ambos deben revisarse. Peor aún: con relojes desviados, el resultado puede depender del reloj defectuoso, no de la causalidad.T3#
Mi prompt original#
[MXHYB-20260926-A T3] Para la ficha de Puente, extrae literalmente estos tres valores del texto, sin explicaciones ni consultar nada: «nombre=Puente; nodos=A,B; política=conservar conflictos». Devuelve solo tres líneas con formato clave=valor.Respuesta híbrida — local#
🖥️ nombre=Puente
nodos=A,B
política=conservar conflictos
Respuesta íntegramente cloud#
nombre=Puente
nodos=A,B
política=conservar conflictosT4#
Mi prompt original#
[MXHYB-20260926-A T4] Probemos el diseño de Puente con este historial. Parten del mismo archivo con vector (1,1). Desconectados, A lo edita y genera (2,1), B lo borra y genera (1,2). A recibe primero el borrado, luego un duplicado del archivo inicial; B recibe primero la edición y luego un duplicado del borrado. Calcula el estado final de ambos y demuestra qué propiedades debe cumplir la fusión para coincidir. Explica cómo resolver explícitamente el conflicto con una nueva versión y por qué borrar el tombstone demasiado pronto puede resucitar datos. Señala cualquier ambigüedad de tu propuesta anterior y corrígela. Unas 350 palabras; razonamiento en el chat, sin herramientas ni archivos.Respuesta híbrida — nube#
☁️ Estado inicial: archivo existente con vector `(1,1)`. Luego hay dos operaciones concurrentes: edición de A con vector `(2,1)` y borrado de B con vector `(1,2)`. Ninguna domina a la otra, porque A tiene más información de A y B más información de B.

**Estado final esperado**
- En A, al recibir el borrado `(1,2)`, la fusión detecta concurrencia edición-vs-borrado y debe producir un conflicto explícito: variante editada de A `(2,1)` frente a tombstone de B `(1,2)`, con vector fusionado `(2,2)`.
- El duplicado del archivo inicial `(1,1)` queda dominado por `(2,2)`, así que se ignora.
- En B, al recibir la edición `(2,1)`, obtiene el mismo conflicto edición-vs-borrado con vector `(2,2)`.
- El duplicado del borrado `(1,2)` queda dominado por `(2,2)` o ya está incluido como variante/tombstone, así que no cambia nada.

Por tanto, ambos terminan con un estado conflictivo convergente: “archivo no resuelto”, con la edición de A preservada y el borrado de B preservado como intención concurrente. No debe aparecer como archivo normal ni como borrado definitivo hasta que alguien resuelva.

**Propiedades necesarias de la fusión**
La fusión debe ser:
- conmutativa: `merge(edición, borrado) = merge(borrado, edición)`;
- asociativa: el orden de llegada no cambia el resultado final;
- idempotente: duplicados como `(1,1)` o `(1,2)` no alteran el estado;
- inflacionaria causalmente: no pierde dots ni conocimiento causal;
- determinista: las mismas entradas producen el mismo estado.

**Resolución explícita**
Un usuario o regla superior debe crear una nueva operación, por ejemplo en A: “conservar edición y descartar borrado”. Esa resolución incrementa A y genera `(3,2)`, dominando tanto `(2,1)` como `(1,2)`. El nuevo estado contiene el archivo elegido, `conflicts={}`, y un registro causal de que el tombstone conflictivo fue observado y resuelto. Si se elige borrar, se crea un nuevo tombstone `(3,2)` que domina la edición.

**Riesgo de recolectar tombstones**
Si B borra el tombstone demasiado pronto y luego recibe desde A una copia antigua del archivo `(1,1)`, puede no tener memoria causal del borrado `(1,2)`. Entonces podría tratar el archivo viejo como válido y resucitar datos borrados. El tombstone debe conservarse hasta que todos los nodos conocidos hayan reconocido un vector que domina el borrado y no puedan reintroducir estados anteriores.

**Ambigüedad corregida**
Antes dije `merged.deleted=false` en edición-vs-borrado. Eso es ambiguo: podría parecer que el archivo existe. Corrección: el estado debe ser `status=conflict`, sin contenido canónico, con variantes explícitas `{edit_variant, delete_variant}` y vector `(2,2)`.
Respuesta íntegramente cloud#
Estado inicial: archivo vivo con vector `(1,1)`. Durante la desconexión:

- A edita: versión viva `EA = (2,1)`.
- B borra: tombstone `DB = (1,2)`.

Estos vectores son concurrentes: `(2,1)` no domina a `(1,2)` y `(1,2)` no domina a `(2,1)`.

**Estado final esperado**

Cuando A recibe el borrado `DB`, fusiona `EA` con `DB` y obtiene un conflicto explícito: “edición de A” frente a “borrado de B”. El archivo no debe quedar simplemente vivo ni simplemente borrado; debe quedar en estado conflictivo con ambas variantes preservadas.

Luego A recibe un duplicado del archivo inicial `(1,1)`. Como `(2,1)` y `(1,2)` dominan causalmente a `(1,1)`, ese duplicado se ignora.

Cuando B recibe la edición `EA`, fusiona `DB` con `EA` y debe obtener exactamente el mismo conflicto. Luego recibe un duplicado del borrado `DB`; como ya está incluido en el estado conflictivo, no cambia nada.

Resultado final en ambos: conflicto `{EA viva, DB tombstone}`, vector resumen `(2,2)` o conjunto causal equivalente, con contenido de A preservado y borrado de B preservado.

**Propiedades necesarias de la fusión**

La fusión debe ser:

- Conmutativa: `merge(EA, DB) = merge(DB, EA)`.
- Asociativa: el agrupamiento de mensajes no cambia el resultado.
- Idempotente: duplicados como `(1,1)` o `DB` no alteran el estado.
- Causal: una versión dominada por el estado actual no puede resucitar ni borrar nada.
- Conservadora ante concurrencia: si edición y borrado son concurrentes, no se descarta ninguno silenciosamente.

**Resolución explícita**

El usuario o una política superior puede resolver el conflicto creando una nueva operación causalmente posterior, por ejemplo en A:

`R = (3,2)` si A ya conoce `DB`, con decisión “mantener contenido editado” o “confirmar borrado”.

Si mantiene el archivo, `R` contiene el contenido elegido y domina tanto `EA` como `DB`. Si confirma borrado, `R` es una nueva tombstone que también domina ambas variantes. Al propagarse, `R` reemplaza el conflicto porque ya no hay concurrencia: hay una decisión posterior.

**Riesgo de recolectar tombstones pronto**

Si B borra la tombstone `DB` antes de que A la haya visto, A puede reenviar una versión viva antigua o concurrente y B no tendrá memoria causal suficiente para saber que hubo un borrado. El archivo puede “resucitar” como si el borrado nunca hubiera existido.

**Ambigüedad corregida**

Antes dije que un conflicto podía tener una variante “visible” elegida determinísticamente. Eso puede inducir a pérdida semántica. Mejor: el estado canónico debe ser un conjunto de variantes concurrentes, sin variante ganadora. La presentación puede destacar una, pero la sincronización debe conservar todas hasta una resolución causal posterior.T5#
Mi prompt original#
[MXHYB-20260926-A T5] Una tarea pequeña para la documentación de Puente: traduce al inglés solo esta frase: «Puente conserva las ediciones concurrentes y pide una resolución explícita de los conflictos». Responde únicamente con la traducción.Respuesta híbrida — local#
🖥️ Puente preserves concurrent edits and requires explicit resolution of conflicts.Respuesta íntegramente cloud#
Puente preserves concurrent edits and requires explicit conflict resolution.T6#
Mi prompt original#
[MXHYB-20260926-A T6] Revisión crítica final de Puente: un compañero propone guardar solo el vector máximo por componente y un único contenido elegido por hash; eliminar tombstones cuando ambos servidores hayan visto su vector; y, tras perder el disco, reutilizar el identificador del servidor con contador cero. Evalúa rigurosamente las tres decisiones, distingue convergencia de conservación de intención y explica un contraejemplo concreto para cada decisión insegura. Formula los supuestos mínimos bajo los que recolectar tombstones sí sería seguro, incluyendo mensajes antiguos en tránsito y réplicas restauradas. Cierra con tres pruebas de propiedades que detectarían estos fallos. Unas 450 palabras, sin ejecutar ni crear archivos.Respuesta híbrida — nube#
☁️ **Hallazgos críticos**
- Guardar solo el vector máximo y un único contenido elegido por hash puede converger, pero no conserva intención. Si A edita “precio=10” con `(2,1)` y B edita “precio=12” con `(1,2)`, el máximo `(2,2)` no indica que hubo dos valores concurrentes; elegir por hash descarta una edición válida sin resolución explícita. Es convergente porque ambos acabarán con el mismo hash, pero semánticamente incorrecto: convierte un conflicto en una pérdida silenciosa.

- Eliminar tombstones cuando ambos servidores “han visto su vector” solo es seguro si esa frase significa reconocimiento causal estable y no simple recepción momentánea. Contraejemplo: B borra `f` con `(1,2)`; A lo ve y ambos eliminan el tombstone. Después llega un mensaje antiguo en tránsito con el archivo inicial `(1,1)`. Si ya no queda memoria del borrado, el archivo puede reaparecer. La convergencia local no basta: hace falta impedir la resurrección de estados causalmente obsoletos.

- Reutilizar el identificador del servidor con contador cero tras perder el disco rompe la unicidad de dots y la causalidad. Contraejemplo: antes del fallo, A generó `(A,5)` y B lo conserva. Tras reinstalarse como `A` desde cero, A genera otra operación `(A,1)`, `(A,2)`... B puede considerarlas dominadas por su vector `{A:5}` e ignorarlas, o confundirlas con historia antigua. Resultado: actualizaciones nuevas desaparecen o se mezclan con generaciones anteriores.

**Convergencia vs intención**
Convergencia significa que réplicas que reciben la misma información terminan en el mismo estado. Conservación de intención significa que operaciones concurrentes no se sobrescriben sin una relación causal o una resolución explícita. Un algoritmo “elige hash menor” puede ser determinista, conmutativo e idempotente, pero sigue siendo una política de pérdida silenciosa.

**Cuándo recolectar tombstones**
La recolección es segura solo bajo supuestos mínimos fuertes:
- membresía cerrada: se conocen todas las réplicas que pueden emitir o reenviar estados;
- identificadores de réplica persistentes y no reutilizados;
- cada réplica ha confirmado de forma duradera un vector que domina el tombstone;
- no existen mensajes antiguos en tránsito que puedan reaparecer sin ser filtrados por memoria causal;
- las restauraciones desde backup conservan, como mínimo, el vector causal reconocido y la información de borrados aún no estabilizados;
- si una réplica pierde esa memoria, debe reincorporarse con nuevo identificador/generación y sincronización completa, no reutilizando contadores antiguos.

Con solo A y B, puede recolectarse un tombstone de B cuando A sabe duraderamente que B sabe que A también ha observado un vector que domina el borrado, y ambos conservan una frontera causal estable que rechaza estados anteriores. Si no hay control de colas, snapshots, backups y mensajes duplicados, la recolección debe retrasarse o mantener un resumen causal compacto.

**Pruebas de propiedades**
- Concurrencia edición-edición: generar dos ediciones desconectadas y verificar que el estado final contiene ambas variantes o una fusión explícitamente marcada, nunca un único contenido arbitrario.
- Borrado contra mensaje antiguo: borrar, sincronizar, intentar reinyectar un estado anterior y comprobar que no resucita el archivo tras compactación.
- Pérdida de disco: reiniciar una réplica con el mismo ID y contador cero debe ser rechazado o detectado; con nuevo ID/generación, sus nuevas operaciones no deben ser confundidas con historia vieja.
Respuesta íntegramente cloud#
La propuesta mezcla convergencia superficial con preservación semántica. Que todos acaben con el mismo estado no basta: Puente debe conservar intenciones concurrentes hasta una resolución causal explícita.

**1. Vector máximo + único contenido por hash**

Es inseguro. Guardar solo el máximo componente a componente, por ejemplo unir `(2,1)` y `(1,2)` en `(2,2)`, destruye la información de que eran versiones concurrentes. Si además se elige un único contenido por hash, se obtiene convergencia, pero con pérdida silenciosa.

Contraejemplo: A y B parten de `x=0` con `(1,1)`. Desconectados, A escribe `x=10` → `(2,1)` y B escribe `x=20` → `(1,2)`. Al sincronizar, ambos guardan vector `(2,2)` y el contenido con hash menor. Convergen, sí, pero la edición perdedora desaparece y el vector resultante finge que existe una versión que causó ambas decisiones, aunque nadie resolvió el conflicto.

Corrección: el estado debe contener un conjunto de variantes concurrentes o un registro de conflicto; el vector máximo puede ser resumen, no sustituto del historial causal relevante.

**2. Eliminar tombstones cuando ambos servidores hayan visto su vector**

Puede ser seguro solo bajo supuestos estrictos, pero la frase es incompleta. Si hay exactamente A y B, almacenamiento estable, identificidades persistentes, canales que no entregan mensajes anteriores tras el acuse, y ambos han confirmado haber integrado una versión posterior que domina la tombstone, entonces se puede recolectar.

Contraejemplo inseguro: B borra `f` con `(1,2)`. A aún tiene en una cola antigua una edición viva `(2,1)` enviada antes o durante la partición. Ambos intercambian acuses de la tombstone y B la recolecta. Después llega el mensaje viejo `(2,1)` a B o B restaura una copia anterior que no recordaba la tombstone. Si no queda memoria causal del borrado, el archivo puede resucitar o volver a conflicto falso.

Supuestos mínimos para GC: membresía cerrada o épocas explícitas; todos los miembros de la época han persistido un estado que domina la tombstone; no existen remitentes autorizados capaces de enviar estados no dominados; los canales o logs garantizan que mensajes antiguos anteriores a la barrera han sido drenados, descartados por época, o serán rechazados por un filtro causal persistido; las restauraciones desde backup deben traer un vector de réplica/época no ambiguo o requerir resincronización completa antes de emitir cambios. En la práctica, conservar un “floor” causal persistente por ruta o por réplica evita aceptar operaciones por debajo de lo ya recolectado.

**3. Reutilizar identificador con contador cero tras perder disco**

Es muy inseguro. Los identificadores de réplica y contadores forman la unicidad de operaciones. Reutilizar `A` con contador cero hace indistinguibles operaciones nuevas de antiguas o dominadas.

Contraejemplo: antes del fallo, A emitió `(5,3)` y B lo conserva. A pierde disco, vuelve como `A` contador `0`, edita y emite `(1,3)` o `(1,0)`. B puede tratarlo como antiguo y descartarlo, o mezclarlo causalmente con operaciones previas de A. Peor: si reaparecen mensajes antiguos de A, pueden colisionar con nuevos `op_id`. Resultado: pérdida, resurrección o divergencia.

Corrección: tras pérdida de disco, generar nueva identidad de réplica o recuperar contador/epoch desde almacenamiento duradero. Alternativamente, reincorporarse mediante protocolo de rejoin que asigna nueva época y prohíbe emitir operaciones hasta descargar un snapshot válido.

**Pruebas de propiedades**

- Concurrencia preservada: para dos ediciones concurrentes distintas, tras cualquier orden y duplicación de mensajes, ambas variantes siguen presentes hasta una resolución explícita.
- No resurrección tras borrado: una versión viva no dominante enviada antes de una tombstone recolectada no puede recrear el archivo.
- Identidad única: después de crash/rejoin, ninguna operación nueva puede compartir `op_id` ni ser ordenada falsamente bajo una época anterior.Procedencia#
Extraído de los campos prompt y response de turn-1.json a turn-6.json de cada ejecución. Los seis prompts coinciden con el fixture prompts.json. No he reescrito ni corregido las respuestas. La tabla de consumo y los límites de la comparación figuran en las secciones anteriores de este artículo.